Làm video podcast có minh hoạ 3D bằng AI
Cách làm video podcast có minh hoạ 3D bằng AI từ clip nói chuyện 155 giây, ra video dọc 141,6 giây. Mình nhờ AI Agent lên plan có hình 3D thật, đổi sang nguồn nét hơn, cho người nói hoà vào nền kem, chỉ cắt chữ thừa và chọn hook từ đúng lời người nói.
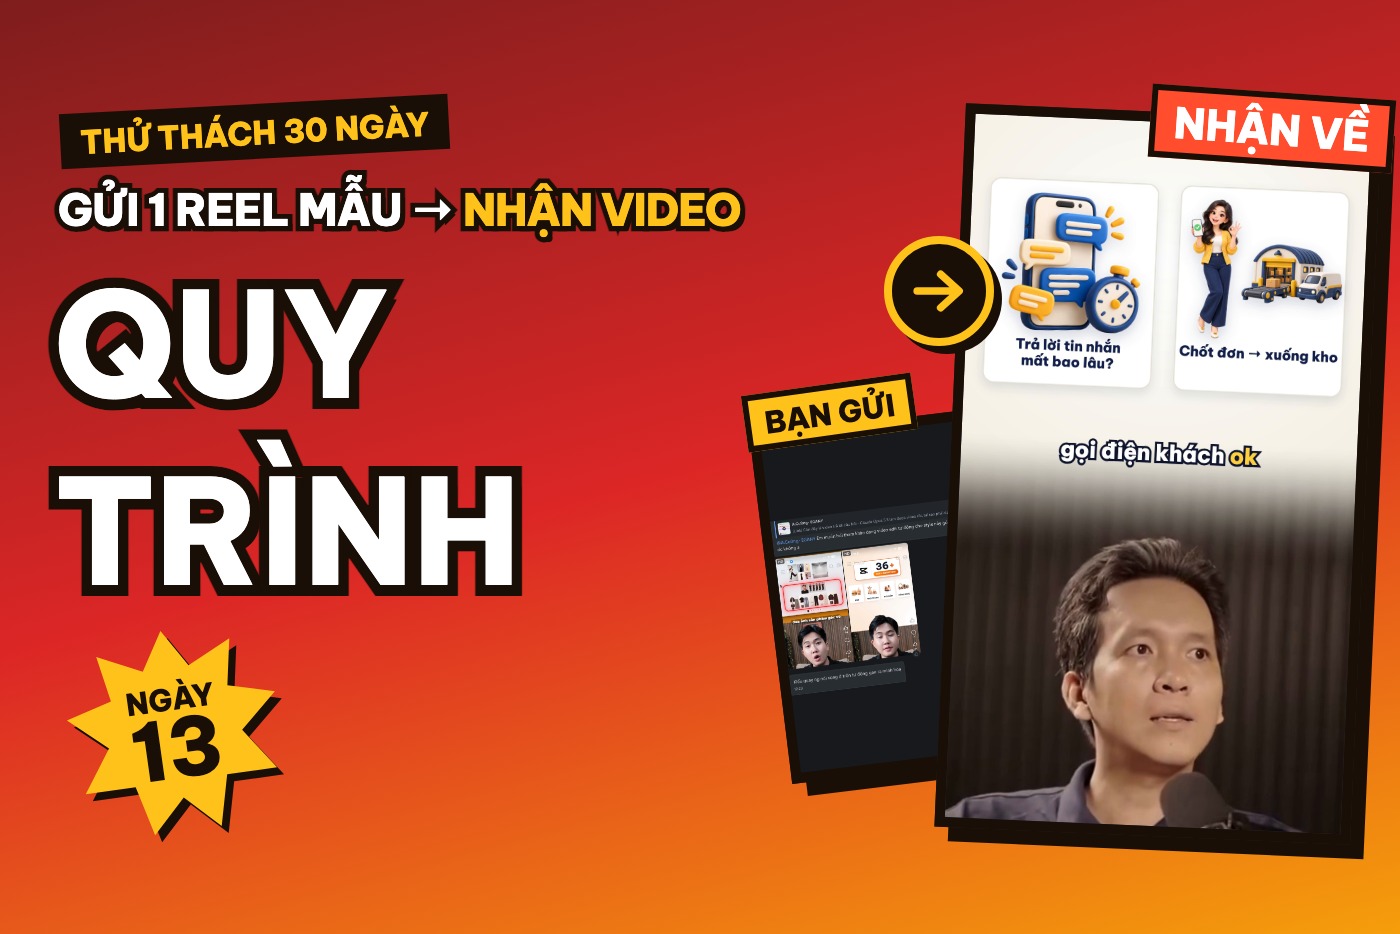
Muốn làm video podcast có minh hoạ 3D bằng AI, kiểu người nói ở nửa dưới và hình tự hiện ở nửa trên đúng lúc nói? Cái khó là mỗi hình phải bật ra đúng chữ, và chỗ nối giữa người nói với khung minh hoạ không được lộ đường cắt. Bài này kể cách mình làm video "Quy trình xuất sắc" trong Thử thách 30 ngày: 5 tin nhắn, 4 lượt chỉnh trên bản plan, đổi nguồn giữa chừng, ra video 141,6 giây.
Bài này dành cho chủ doanh nghiệp và người làm podcast muốn biến clip nói chuyện thành video dọc có hình minh hoạ.
Video podcast có minh hoạ 3D làm bằng AI
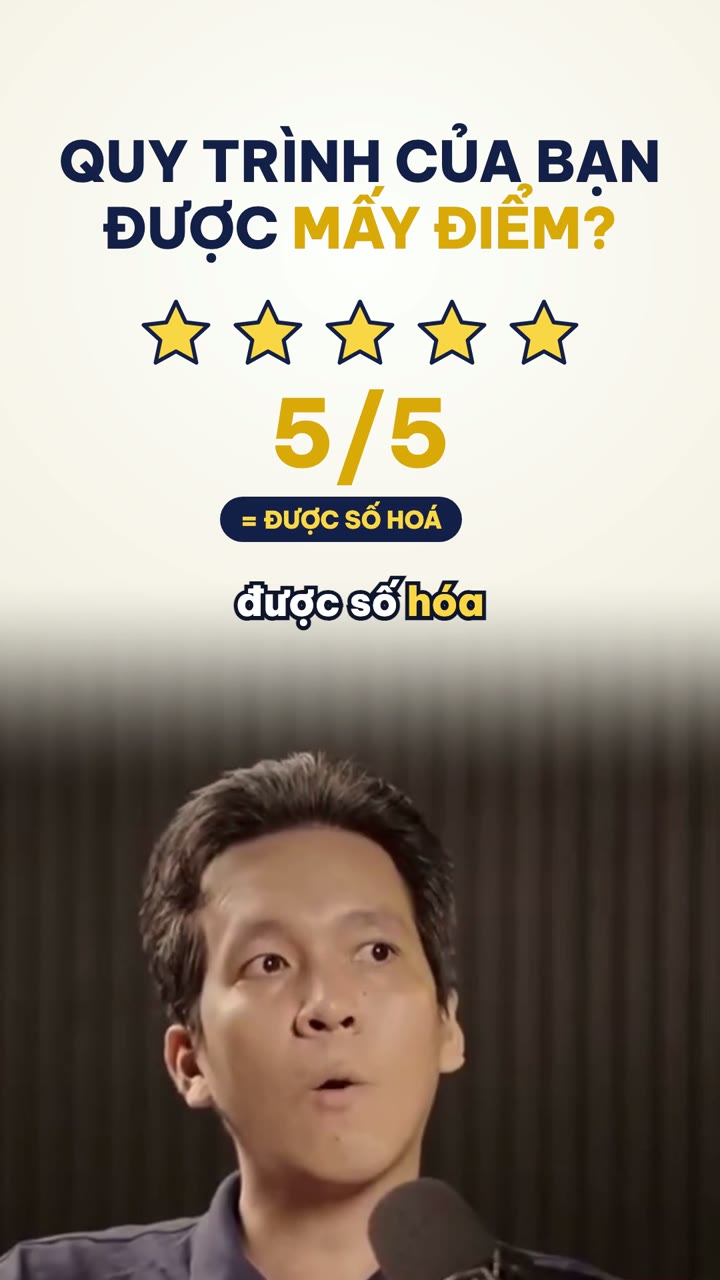 Xem video
Video là đoạn podcast của anh Cường về tiêu chí chấm điểm một quy trình trước khi đưa AI vào tự động hoá. Nửa trên là 24 hình 3D đất sét tông navy và vàng, nửa dưới là người nói, phụ đề tô vàng từ đang nói nằm ngay chỗ giáp.
Bước 1: Gửi câu hỏi kèm reel mẫu, xin plan trước
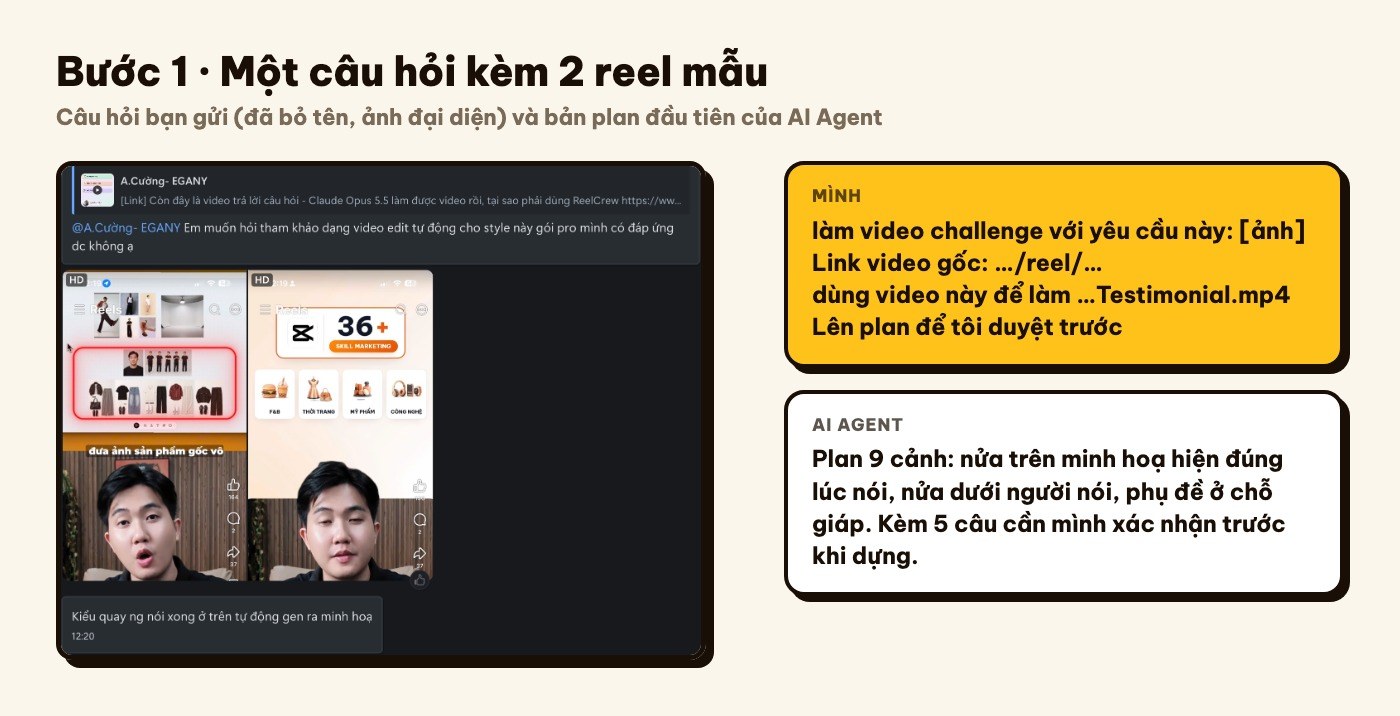
Một bạn trong cộng đồng gửi 2 reel mẫu và hỏi: "Em muốn hỏi tham khảo dạng video edit tự động cho style này gói pro mình có đáp ứng dc không ạ". Bạn ghi thêm: "Kiểu quay ng nói xong ở trên tự động gen ra minh hoạ". Mình chọn một clip phỏng vấn có sẵn để làm thử, rồi nhắn AI Agent:
làm video challenge với yêu cầu này: [ảnh] Link video gốc: …/reel/… dùng video này để làm …Testimonial.mp4 Lên plan để tôi duyệt trước
AI trả về plan 9 cảnh. Nửa trên là minh hoạ hiện đúng lúc người nói nhắc tới, nửa dưới là người nói, phụ đề ngắn ở chỗ giáp. Kèm theo là 5 câu cần mình xác nhận, như một con số máy nghe nhầm ("52 ha" hay "5 ha") và màu chủ đạo.
Vì sao xin plan trước khi dựng? Kiểu video này tốn công nhất ở lớp minh hoạ. Sửa trên trang plan chỉ mất vài phút, còn render lại lớp minh hoạ thì mất cả chục phút mỗi lần.
Bước 2: Plan đầu chỉ có chữ, mình đòi hình minh hoạ thật
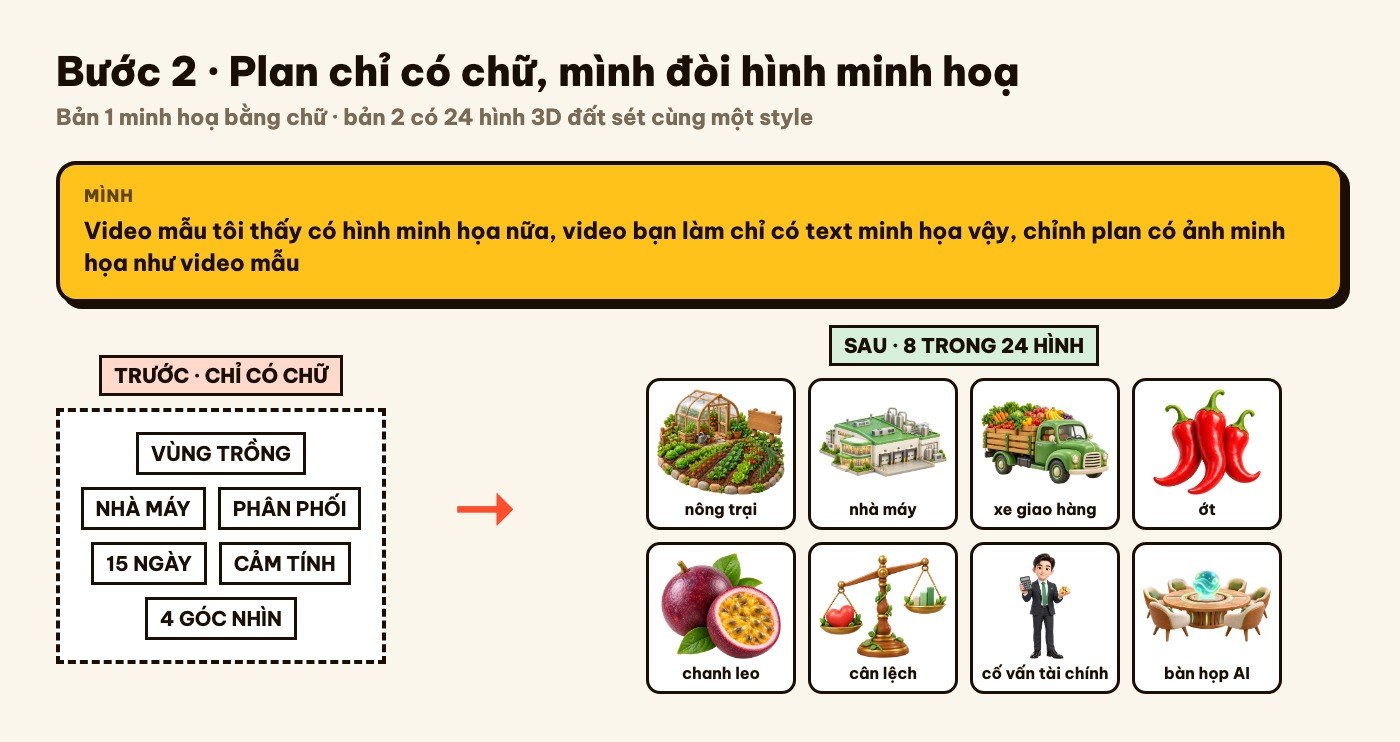
Mở trang plan, mình thấy các cảnh mới chỉ có chữ thay cho hình. Trong khi điểm hút của reel mẫu chính là hình. Mình nhắn:
Video mẫu tôi thấy có hình minh họa nữa, video bạn làm chỉ có text minh họa vậy, chỉnh plan có ảnh minh họa như video mẫu
AI tạo 24 hình 3D đất sét cùng một style: nông trại, nhà máy, xe giao hàng, cái cân lệch, 4 cố vấn, bàn họp AI. Mỗi cảnh trong plan thành một khung 9:16 thật, hình đặt đúng chỗ sẽ dựng.
Vì sao phải thấy hình ngay trong plan? Duyệt chữ "nhà máy" không cho biết video trông ra sao. Nhìn khung mẫu có hình thật, mình biết ngay style có hợp không trước khi tốn lượt render.
Bước 3: Clip đầu bị bỏ, đổi sang podcast của anh Cường
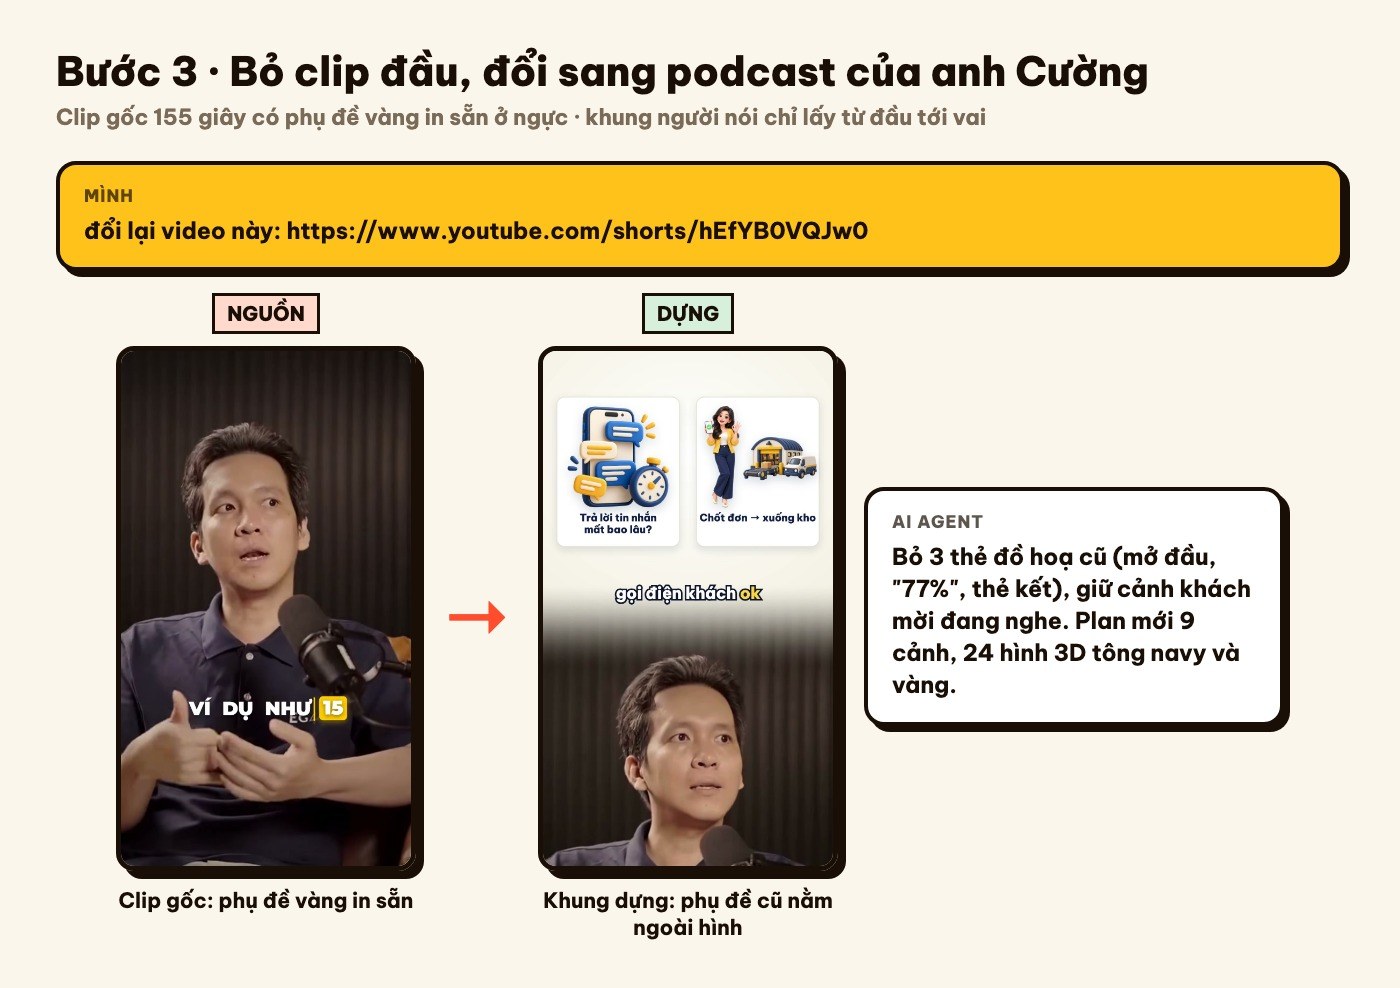
Ngay từ plan đầu, AI đã báo clip phỏng vấn chỉ có 368×640, phóng to bằng AI thì mặt người nói vẫn hơi mềm. Mình đổi sang một clip podcast nét hơn, bỏ luôn bản plan và 24 hình đã làm:
đổi lại video này: https://www.youtube.com/shorts/hEfYB0VQJw0
Clip mới dài 155 giây, nét 1080×1920, nhưng có 3 thứ in sẵn. Phụ đề vàng in ở ngực: AI chỉ lấy khung từ đầu tới vai nên phụ đề cũ nằm ngoài hình. Ba thẻ đồ hoạ cũ (mở đầu, thẻ "77%", thẻ kết): bỏ. Cảnh khách mời đang nghe: giữ lại cho đỡ đơn điệu. AI làm lại 24 hình mới tông navy và vàng, plan vẫn 9 cảnh.
Vì sao đổi nguồn ở bước plan? Lúc này mới mất bản plan và bộ hình, khoảng 1 giờ 20 phút, chưa tốn lượt render nào. Người nói chiếm nửa khung hình suốt video, nên nguồn nét đáng giá hơn bộ hình đã làm.
Bước 4: Bốn ý sửa về màu, chỗ nối, chữ thừa và outro
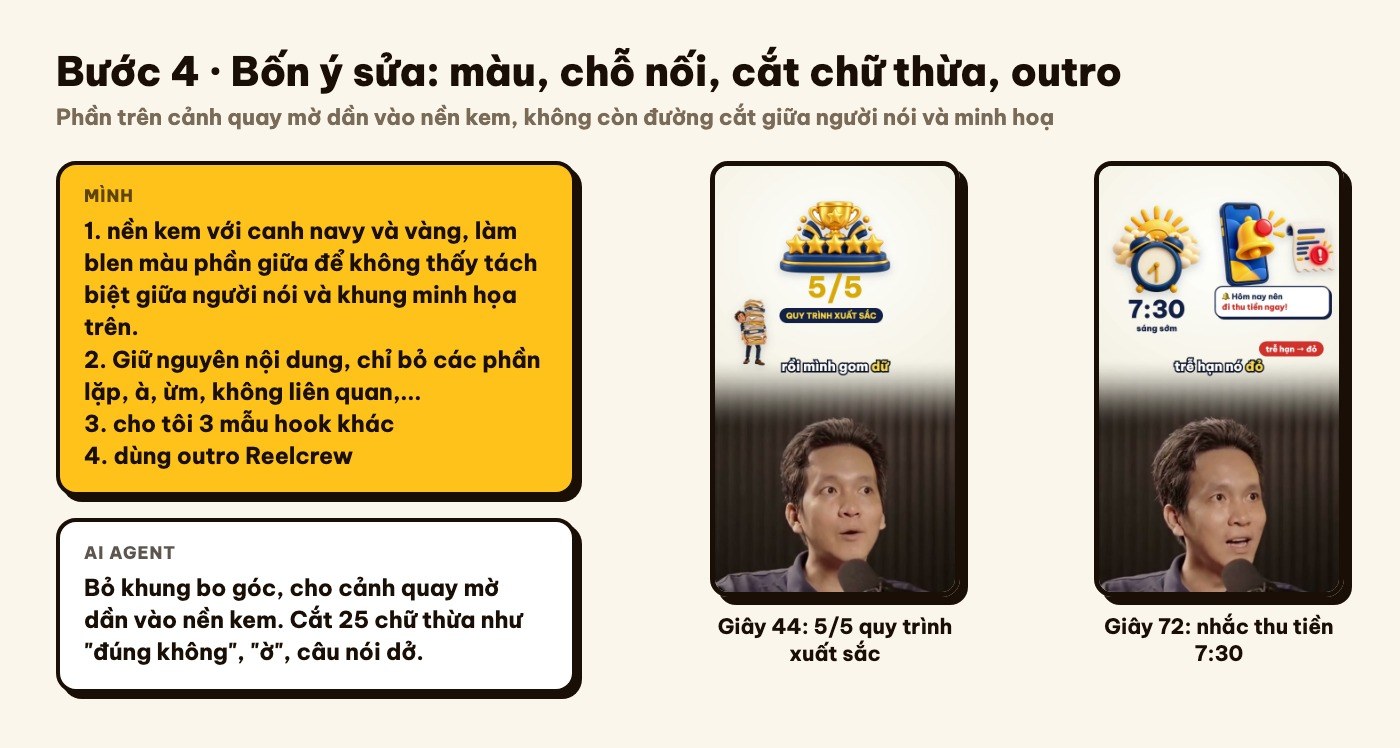
Plan mới đúng nội dung, nhưng khung người nói vẫn là một ô bo góc tách khỏi phần minh hoạ. Mình gửi 4 ý cùng lúc:
1. nền kem với canh navy và vàng, làm blen màu phần giữa để không thấy tách biệt giữa người nói và khung minh họa trên. 2. Giữ nguyên nội dung, chỉ bỏ các phần lặp, à, ừm, không liên quan,... 3. cho tôi 3 mẫu hook khác 4. dùng outro Reelcrew
AI bỏ khung bo góc, cho phần trên cảnh quay mờ dần vào nền kem và ám nhẹ tông ấm. Khi dựng, nó cắt 25 chữ thừa theo mốc thời gian từng chữ: các câu "đúng không", tiếng "ờ", một câu nói dở "Mà khách hàng B2B không phải là…".
Vì sao chỉ cắt chữ thừa, không rút gọn? Đây là lời một người thật đang giảng. Cắt ý thì dễ làm sai nghĩa, còn bỏ "ờ, đúng không" chỉ làm nhịp gọn hơn mà nội dung giữ nguyên.
Bước 5: Chọn hook A từ đúng câu người nói
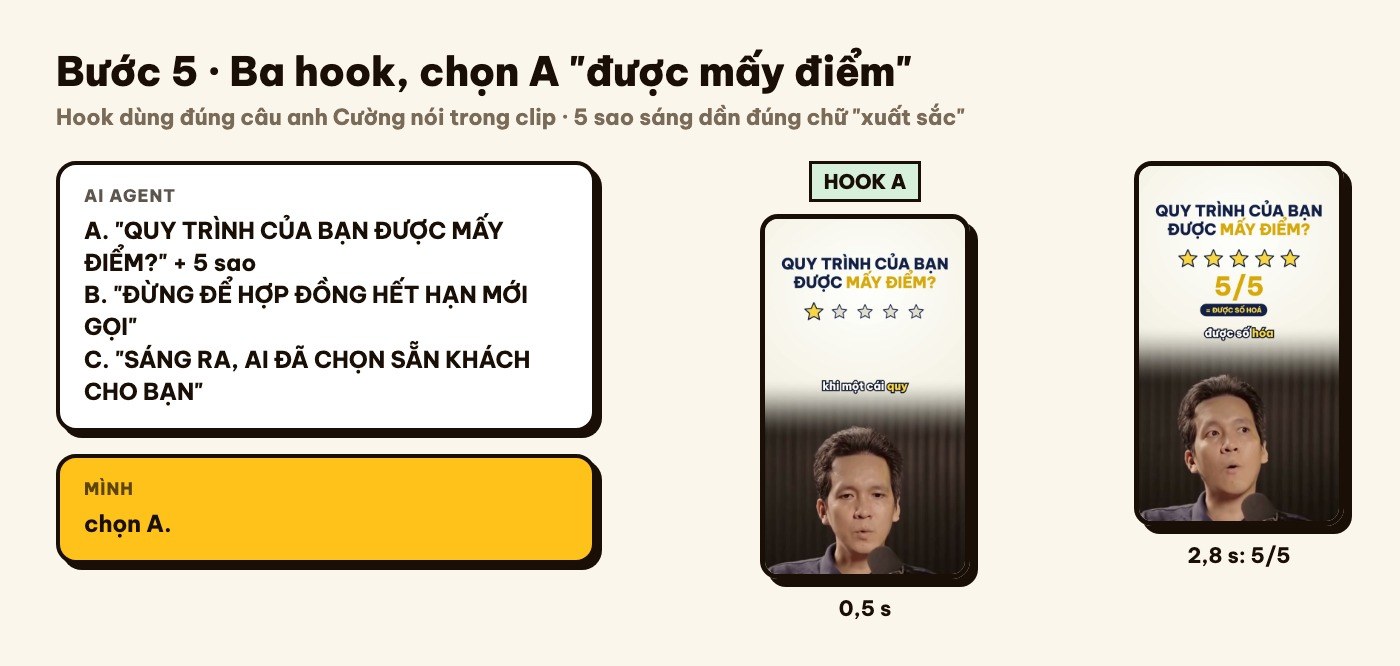
AI đưa 3 hook, mỗi hook dùng một câu anh Cường nói trong clip. Hook A là "Quy trình của bạn được mấy điểm?" với 5 ngôi sao. Hook B là "Đừng để hợp đồng hết hạn mới gọi", hook C là "Sáng ra, AI đã chọn sẵn khách cho bạn". Mình trả lời gọn:
chọn A.
AI dựng hook 3,1 giây ở đầu video: 5 sao sáng dần lên 5/5 đúng lúc anh Cường nói "xuất sắc". Lớp minh hoạ được render riêng thành một lớp trong suốt rồi chồng lên cảnh quay, có thêm nhạc nền nhẹ và tiếng "pop" khi hình hiện. Khi giao, AI nói rõ nó chỉ kiểm được hình, không nghe được. Nó chỉ ra 4 chỗ nhờ mình nghe lại: chỗ nối hook, 2 chỗ đã cắt câu và đoạn tiếng pop dày.
Vì sao hook phải là lời thật của người nói? Hook đọc bằng giọng khác sẽ lệch với cả video phía sau. Lấy một câu có sẵn trong clip, người xem nghe liền mạch từ giây đầu tới cuối.
Lưu đồ chỉnh sửa
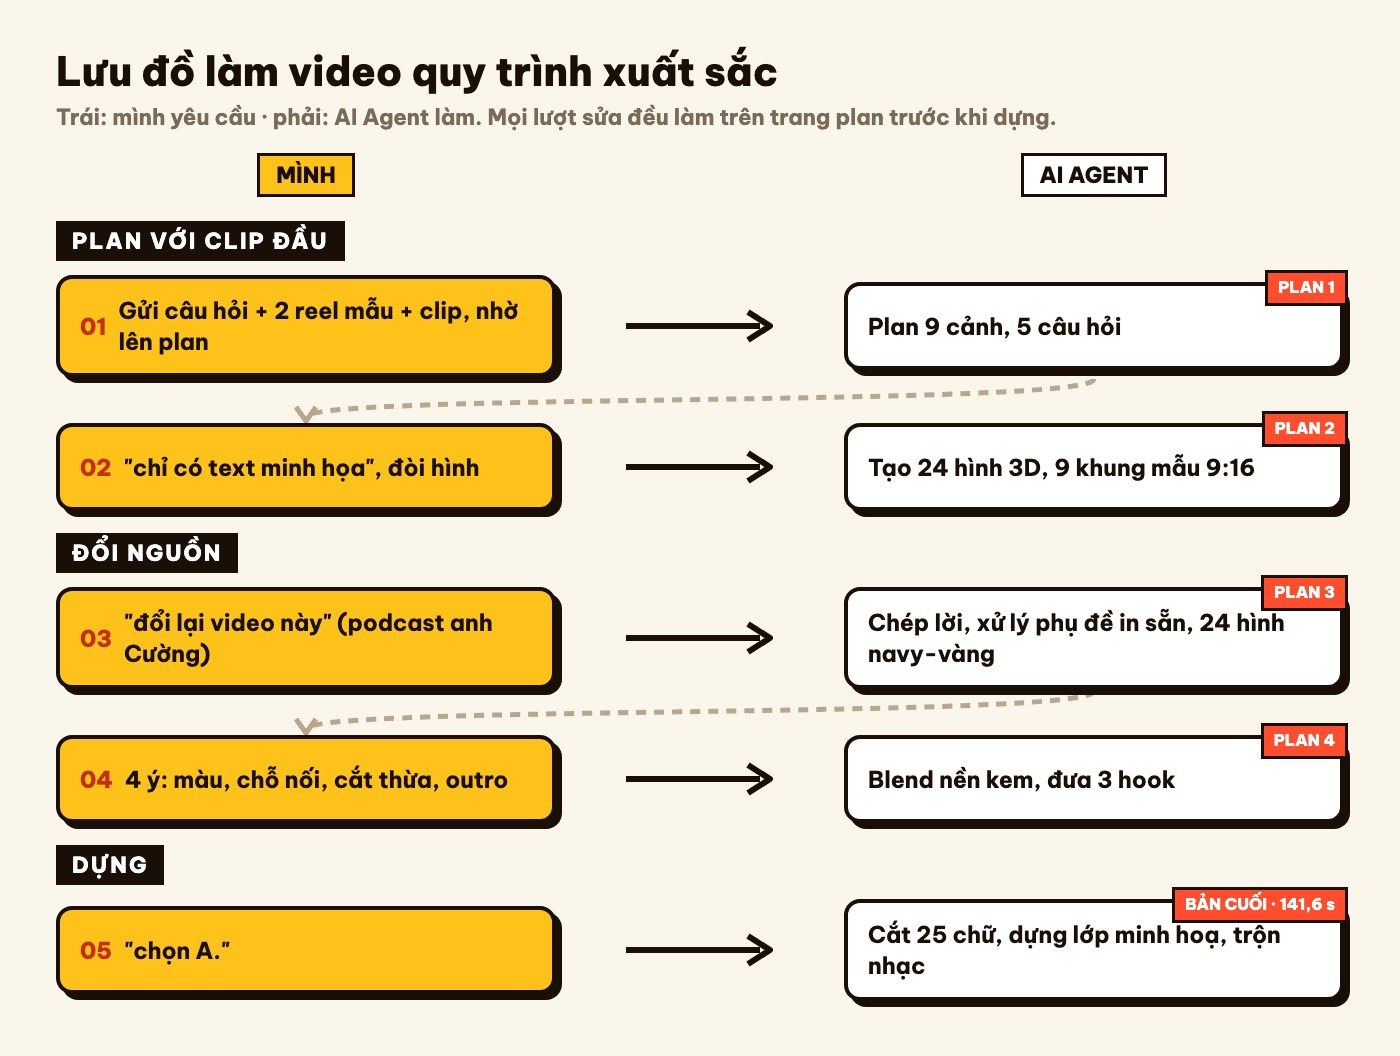
- Câu hỏi + 2 reel mẫu + clip đầu → AI lên plan 9 cảnh, 5 câu hỏi.
- "chỉ có text minh họa" → AI tạo 24 hình 3D, 9 khung mẫu 9:16.
- Đổi sang podcast anh Cường → AI chép lời, xử lý phụ đề in sẵn, làm lại 24 hình navy và vàng.
- 4 ý sửa → AI cho người nói hoà vào nền kem, đưa 3 hook.
- "chọn A." → AI cắt 25 chữ thừa, dựng lớp minh hoạ, ra bản 141,6 giây.
Prompt mẫu để làm video podcast có minh hoạ bằng AI
Đây là 4 prompt mình đã dùng, viết lại dạng điền chỗ trống:
Lên plan làm video kiểu người nói ở nửa dưới, minh hoạ tự hiện ở nửa trên như reel mẫu <link>, dùng clip <đường dẫn>. Cho tôi ảnh minh hoạ thật trong từng khung mẫu, duyệt rồi mới dựng.
Nền <màu>, cho phần trên cảnh quay mờ dần vào nền để không thấy tách biệt giữa người nói và khung minh hoạ.
Giữ nguyên nội dung, chỉ bỏ các phần lặp, à, ừm, câu nói dở và đoạn không liên quan.
Cho tôi 3 hook, mỗi hook dùng đúng một câu người nói trong clip, kèm chữ lớn và hình cho 3 giây đầu.
Muốn xem thêm cách dựng từ clip người thật nói, bạn đọc bài video bản tin bất động sản từ clip môi giới. Cách duyệt plan bằng khung mẫu trước khi render cũng giống bài video mẹo nội thất phòng khách.
Kết quả
- Video: 141,6 giây, dọc 9:16 (1080×1920), giọng gốc của người nói, 24 hình minh hoạ 3D, phụ đề tô vàng từ đang nói.
- Clip gốc 155 giây: bỏ 3 thẻ đồ hoạ cũ và 25 chữ thừa, thêm hook 3,1 giây.
- 5 tin nhắn, 4 lượt chỉnh trên plan, 1 lượt dựng; 3 giờ 42 phút từ tin nhắn đầu đến video, trong đó 2 giờ 22 phút từ lúc đổi nguồn.
Bài học khi làm video podcast, talking head với AI Agent
- Chọn nguồn nét trước khi làm minh hoạ. Clip 368×640 kéo cả video xuống, đổi sớm đỡ tốn hơn đổi muộn.
- Đòi hình thật trong plan. Khung mẫu có hình 3D cho thấy style ngay, chữ mô tả thì không.
- Xoá đường nối giữa hai nửa. Cho cảnh quay mờ vào nền minh hoạ, người xem thấy một khung hình chứ không phải hai.
- Chỉ cắt chữ thừa, giữ ý người nói. Với lời giảng thật, bỏ "ờ, đúng không" là đủ gọn.
- Lấy hook từ chính lời trong clip. Câu có sẵn giữ giọng liền mạch, không phải thu thêm.
Gửi nội dung của bạn
Thử thách 30 ngày vẫn đang chạy: bạn gửi clip, file Word, link bài viết hay một tấm ảnh, team AgentVid làm video miễn phí. Gửi tại egany.me/guiytuong.lamvideo.
Tự làm video như thế này
Video này dựng riêng bằng Reelcrew; kiểu gần nhất có sẵn trong gói Pro là talking-head-highlight-short. Bạn đưa vào một clip nói chuyện hay podcast dài, nhận về video dọc đã cắt ậm ừ và có phụ đề. Lớp thiết kế như thẻ chữ, chia màn hình, hiệu ứng theo lời đi kèm skill motion-fx-kit.